Guía completa del servicio posventa de servidores de IA, parte 1: los cuatro niveles de desafíos posventa, de los componentes al rack
Publicado: Actualizado:
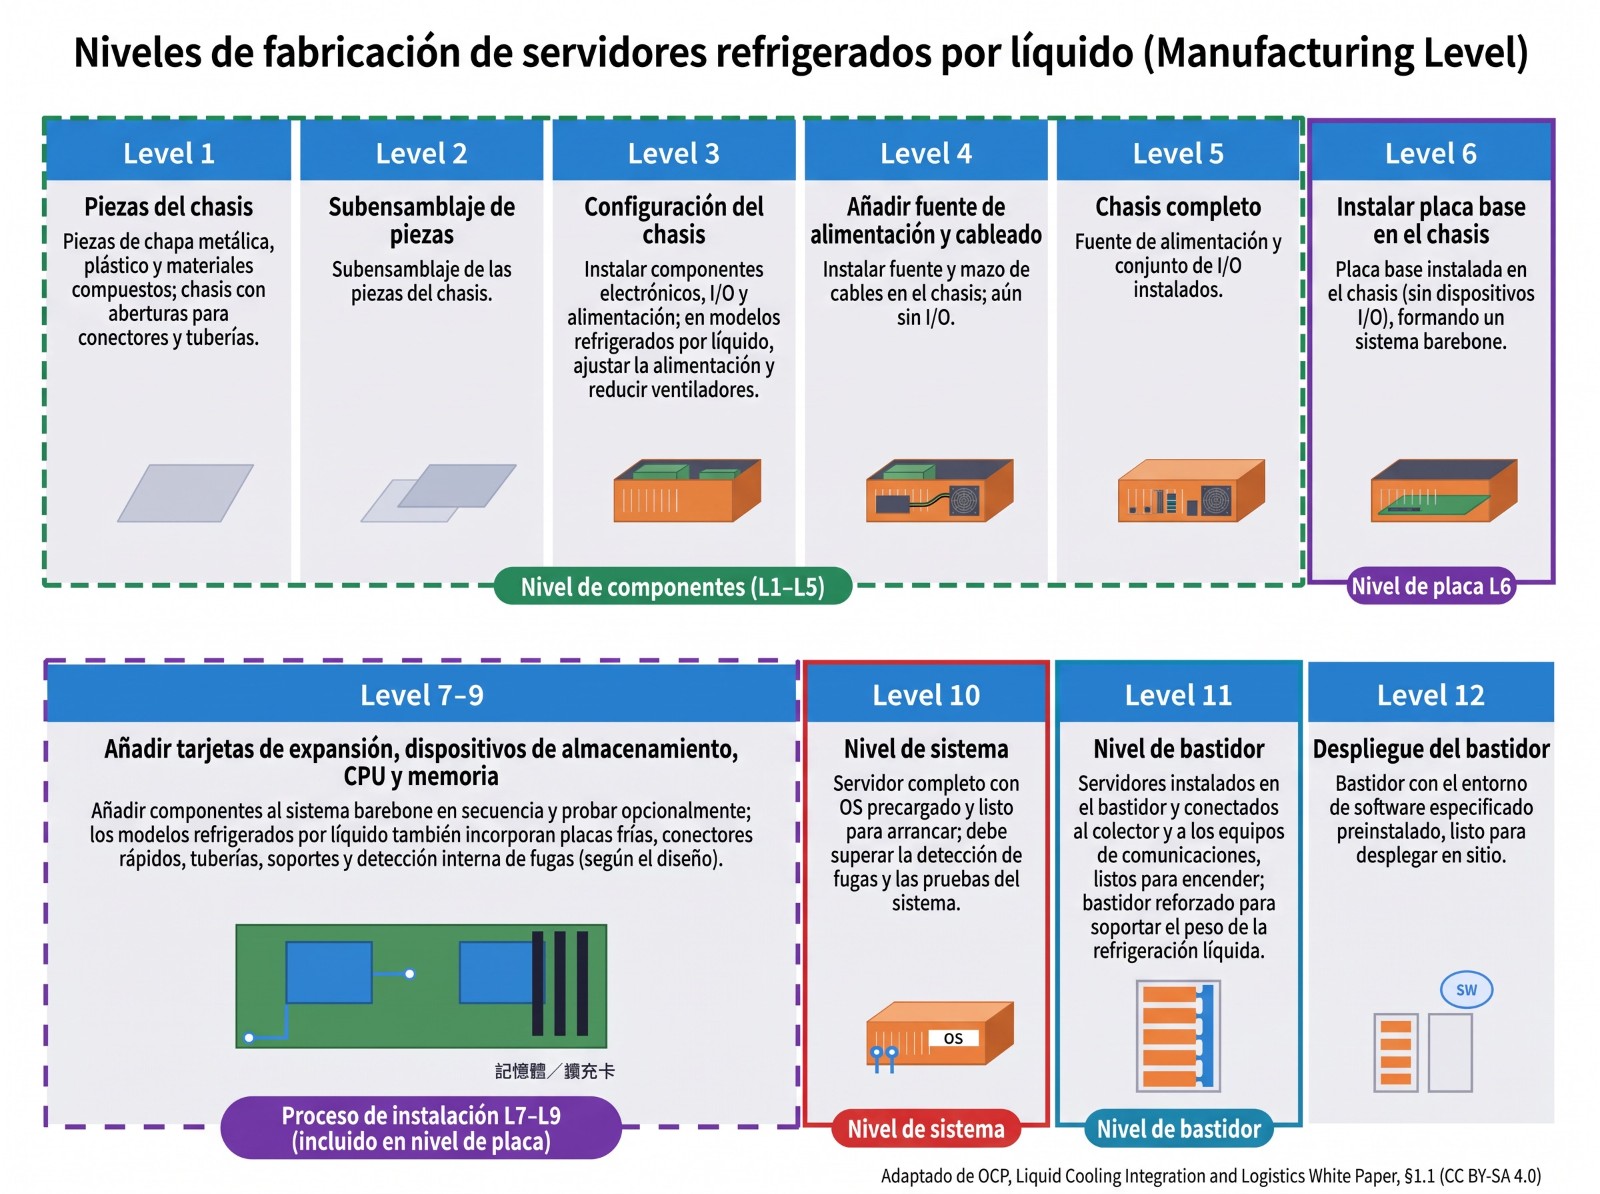
La escala de despliegue de los servidores de IA sigue creciendo, y las formas del equipo se apilan capa por capa, desde componentes y placas hasta sistemas completos y racks. La previsión de IDC de 2022 señalaba que cerca de la mitad de los productos y activos ya estaban conectados (49,6 %), y se esperaba que subiera al 67,2 % en tres años[2]. Pero para que los datos se conviertan en decisiones posventa eficaces, es imprescindible que los registros de reparación se enlacen entre capas, en lugar de quedarse aislados en una sola. El sector suele recurrir al Manufacturing Level (L1–L12) propuesto por AMAX para describir el proceso de integración del equipo, desde los componentes hasta el rack[1]. Los servidores de IA emplean mayoritariamente refrigeración líquida, y su clasificación añade a la base de refrigeración por aire elementos de refrigeración líquida como placas frías, conectores rápidos y tuberías[6] (Figura 1): L1–L5 son piezas del chasis y subensamblajes; L6 es la placa base instalada en el chasis; L7–L9 añaden, por orden, tarjetas de expansión, dispositivos de almacenamiento, CPU y memoria; L10 es un servidor completo con SO precargado y capaz de arrancar, que debe superar la detección de fugas y las pruebas de sistema; L11 son nodos instalados en el rack, conectados al colector y listos para encenderse; L12 es un rack completo listo para desplegarse directamente en el sitio. | ||||
Figura 1: Clasificación de fabricación (Manufacturing Level) de servidores con refrigeración líquida [6] | ||||
Desde la perspectiva posventa, cada capa tiene patrones de fallo, atribución de responsabilidades y lógica de reparación distintos, y por tanto necesidades de servicio y soluciones diferentes. Este artículo las agrupa en cuatro escenarios: nivel de componente (Component, L1–L5), nivel de placa (L6, incluidos los añadidos de L7–L9), nivel de sistema completo (L10) y nivel de rack (L11), y por último presenta cómo wareconn conecta las distintas capas. |
I. Nivel de componente (Component): tratamiento por categorías y determinación de responsabilidades | ||||
El nivel de componente parte del chasis, las fuentes de alimentación, los cables y los backplanes de L1–L5, y se extiende a los componentes funcionales sustituibles de forma independiente, como GPU, memoria, dispositivos de almacenamiento y tarjetas de red. El flujo de reparación es: inspección de entrada → análisis de fallos (FA) → reparación o sustitución → prueba de salida. | ||||
Los precios unitarios de los componentes varían mucho y el origen de los fallos involucra a varias partes, por lo que las necesidades de servicio posventa se resumen principalmente en dos: |
➤ Componentes de bajo coste: sustitución rápida y control de repuestos | ||||
Los componentes de bajo coste se sustituyen directamente con repuestos, sin analizarlos uno por uno; los de alto coste, como GPU y HBM (memoria de alto ancho de banda), siguen el proceso RMA (autorización de devolución de mercancía) y se dictaminan mediante FA tras la devolución, evitando sustituciones erróneas o envíos repetidos a reparación que encarecen el inventario de repuestos. | ||||
➤ Componentes de alto coste: qué falló y de quién es la responsabilidad | ||||
Además de determinar "qué falló", en los componentes de alto coste hay que rastrear si el fallo corresponde al cliente, al proceso o al proveedor, es decir, CID (causa atribuible al cliente), PID (causa atribuible al proceso) y VID (causa atribuible al proveedor). Si guarda relación con el diseño o el proceso, también hay que confirmar si se han actualizado los programas de prueba y la arquitectura, y formalizarlo mediante un ECN (aviso de cambio de ingeniería). | ||||
Para atender estas dos necesidades, las piezas de alto coste siguen procesos RMA y FA estandarizados, con una correspondencia unificada de códigos de fallo; cada fallo se atribuye a CID, PID o VID, y se controlan las versiones de los ECN y de los programas de prueba. El requisito previo son datos de trazabilidad completos: los números de serie son adecuados para el seguimiento de productos de alto precio unitario, y las estadísticas por lote para comparar productos de gran volumen[3]. |
II. Nivel de placa (L6, incluidos los añadidos de L7–L9): capacidad de reparación y seguimiento de asociaciones | ||||
L6 es el primer punto de inflexión del proceso de integración: la placa base se instala en el chasis y se prueba el encendido, formando una "unidad básica sin componentes añadidos". A continuación, L7–L9 incorporan tarjetas de expansión, dispositivos de almacenamiento, CPU y memoria; los modelos con refrigeración líquida añaden además placas frías y conectores rápidos[6]. Un escenario típico es que la unidad básica arranque con normalidad, pero no lo haga tras añadir la CPU y la memoria: el problema puede estar en la placa base, en algún módulo de memoria o en la compatibilidad entre ambos y la versión de BIOS. | ||||
Las necesidades de servicio posventa del nivel de placa dependen del precio unitario de la placa: |
➤ Placas de bajo coste: gestión gratuita | ||||
El coste de reparación de una placa de bajo coste puede superar el de la propia placa, por lo que lo habitual es sustituirla gratuitamente o darla de baja, según el precio unitario y el contrato. | ||||
➤ Placas de alto coste: capacidad de prueba y reparación | ||||
Cada componente añadido modifica la configuración, y el origen de una anomalía resulta difícil de determinar a simple vista; por ello, reparar placas de alto coste para reutilizarlas exige programas de prueba, técnica de reparación y FA para localizar el fallo, además de contar con suficientes repuestos de componentes de bajo nivel necesarios para la reparación. | ||||
➤ RTV de componentes y registros de reparación | ||||
Los componentes defectuosos de una placa pueden devolverse al proveedor (RTV), para lo cual se requiere el código de error (Error Code) y un certificado de baja, y deben conservarse los registros de reparación para su trazabilidad. | ||||
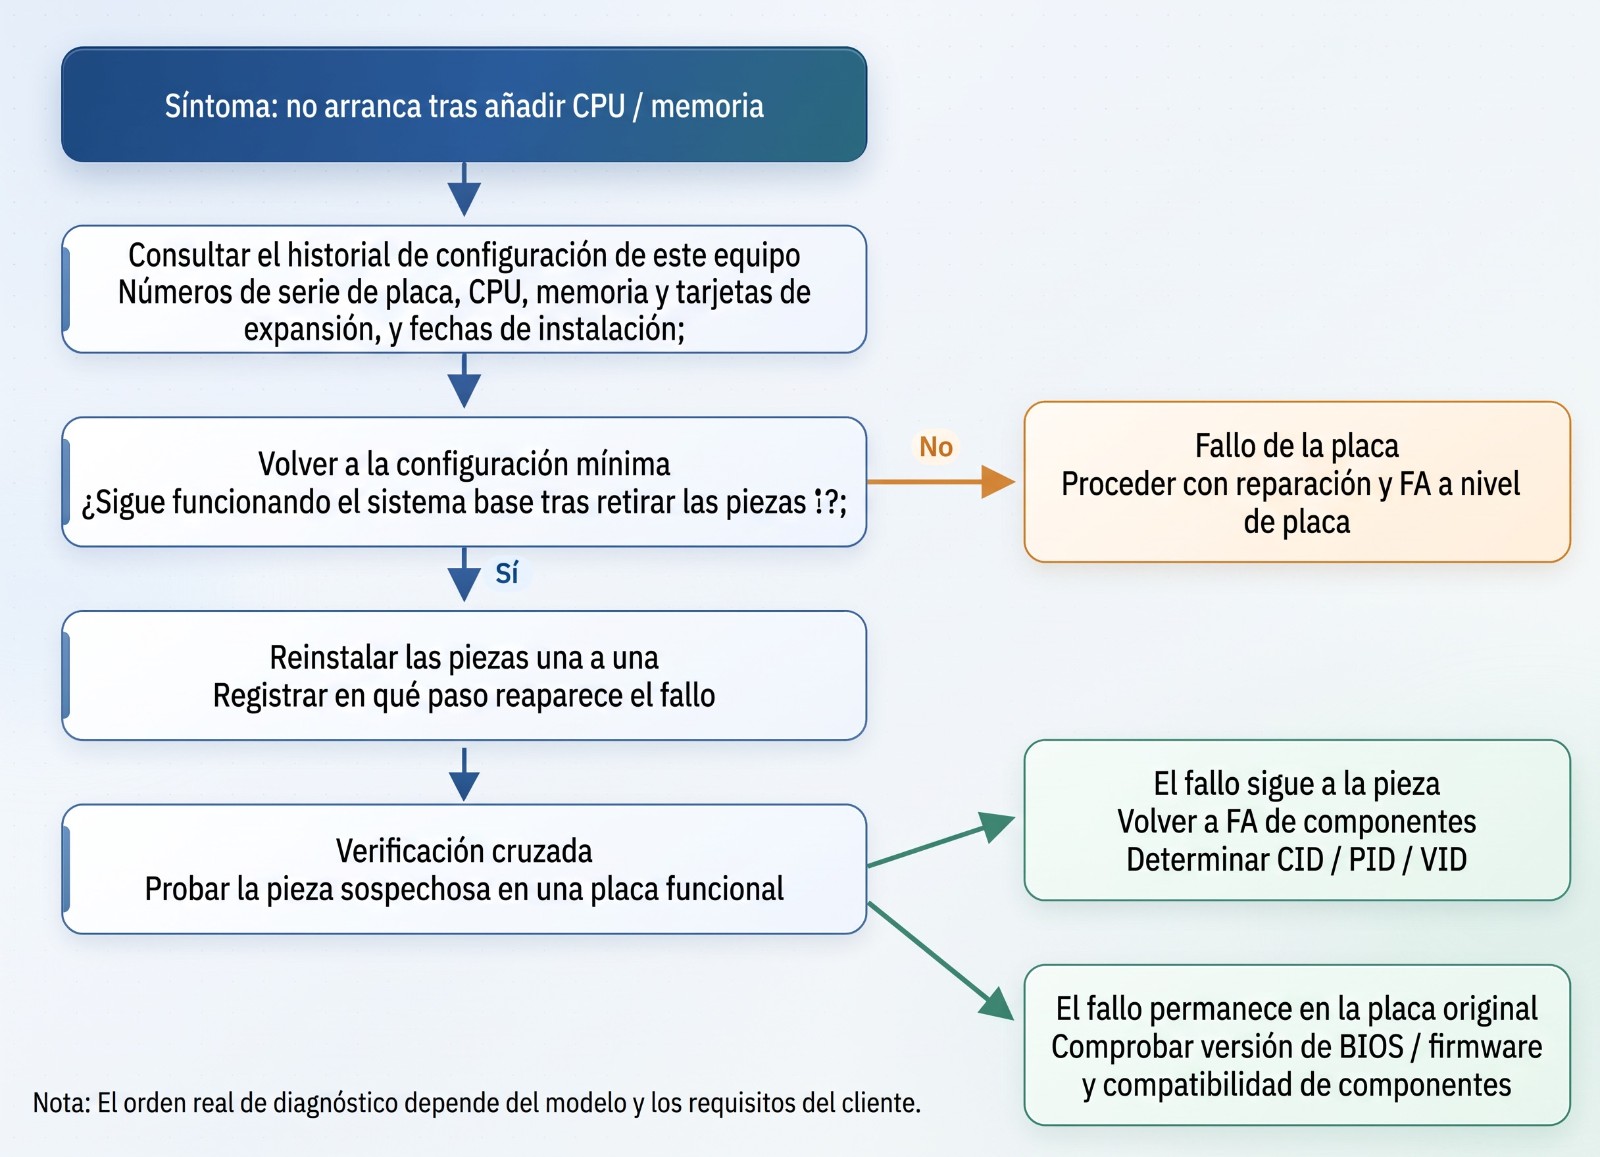
En la práctica, el fallo puede deducirse a partir de los síntomas (véase la Figura 2): primero se confirma si la unidad básica funciona con normalidad, luego se revisan uno por uno los componentes recién añadidos (incluidas las placas frías y los conectores en los modelos con refrigeración líquida) y la versión de BIOS y, si es necesario, se hace una verificación cruzada con otra placa que funcione bien. Para ello el sistema debe registrar la relación de combinación y el historial de sustituciones de las placas y los componentes añadidos, es decir, la "asociación", y gestionar los registros de reparación y el inventario de repuestos. | ||||
Figura 2: Esquema del flujo de diagnóstico de anomalías tras los añadidos de L6 |
III. Nivel de sistema completo (L10): integración de sistemas y verificación mediante repetición de pruebas | ||||
L10 ya es un producto completo, con el hardware en su sitio y el SO y el software integrados. El flujo es: desmontaje del sistema → localización del componente defectuoso → sustitución → remontaje → encendido y prueba de envejecimiento (Burn-in), con lo que el foco pasa de "cambiar componentes" a "operar sobre el sistema completo". | ||||
Las necesidades de servicio posventa del nivel de sistema completo se concentran en la conexión entre sistemas y la verificación posterior a la reparación: |
➤ Sistemas del cliente: la información de reparación y garantía debe poder enlazarse | ||||
Los sistemas completos suelen estar ya incorporados a los sistemas de activos y de órdenes de trabajo del cliente, por lo que la información de reparación y garantía debe integrarse para que el cliente pueda conocer el estado del equipo. | ||||
➤ Información logística: debe poder verse el envío, la recepción y el avance de la reparación | ||||
Los sistemas completos viajan de ida y vuelta entre el cliente y el centro de reparación, por lo que el envío y la recepción, las guías de transporte y el avance de la reparación deben integrarse en tiempo real. |
➤ Verificación mediante repetición de pruebas: reparado no significa sin problemas | ||||
Sustituir la memoria puede provocar problemas de compatibilidad por discrepancia en la versión del firmware, y un envejecimiento incompleto puede hacer que el fallo reaparezca en el cliente, por lo que tras la reparación es necesario verificar con equipos y programas de prueba. | ||||
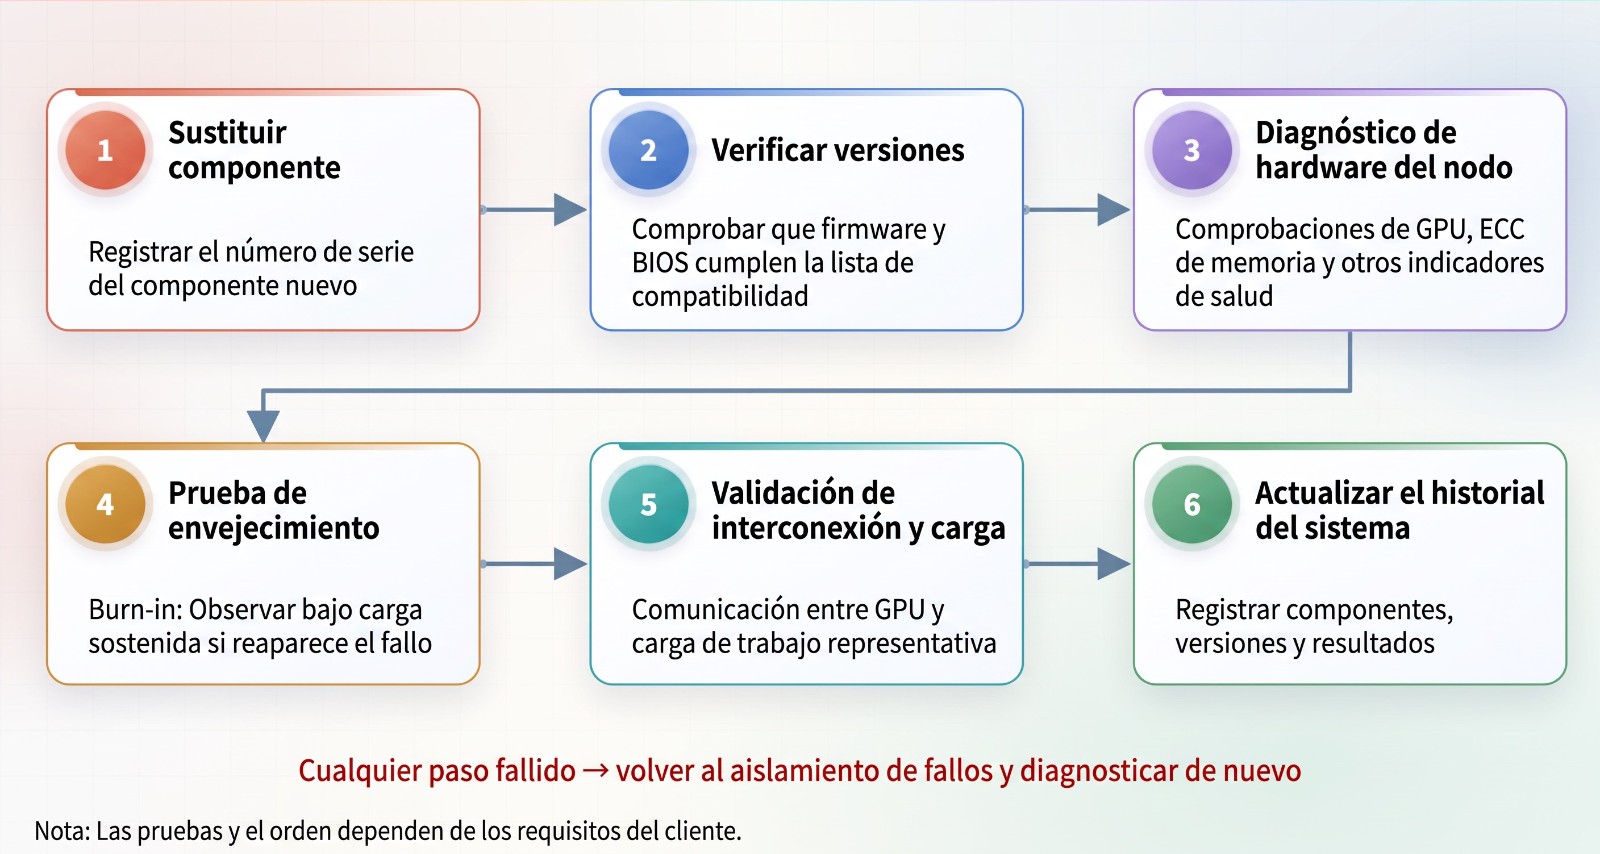
Para atender estas necesidades, puede estandarizarse el proceso de repetición de pruebas tras la sustitución de piezas y resolver la integración en la capa de sistema. La validación de GPU de Google Cloud abarca diagnósticos de bajo nivel, diagnósticos de estado con DCGM (herramienta de gestión de GPU de centros de datos), pruebas de comunicación con NCCL (biblioteca de comunicaciones colectivas) y simulación de cargas de trabajo[9], y algunos proveedores establecen que un nodo que no supere los diagnósticos y las pruebas de estrés no se incorpora al clúster[10]. La repetición de pruebas posterior a la reparación puede inspirarse en ellos (véase la Figura 3), registrando de nuevo en el historial del sistema los resultados, las versiones de firmware y las piezas sustituidas, y conectando mediante API los sistemas del cliente y la información logística. | ||||
Figura 3: Esquema del flujo de repetición de pruebas tras la reparación a nivel de sistema completo[9][10] |
IV. Nivel de rack (L11): minimizar el tiempo de inactividad y controlar los repuestos | ||||
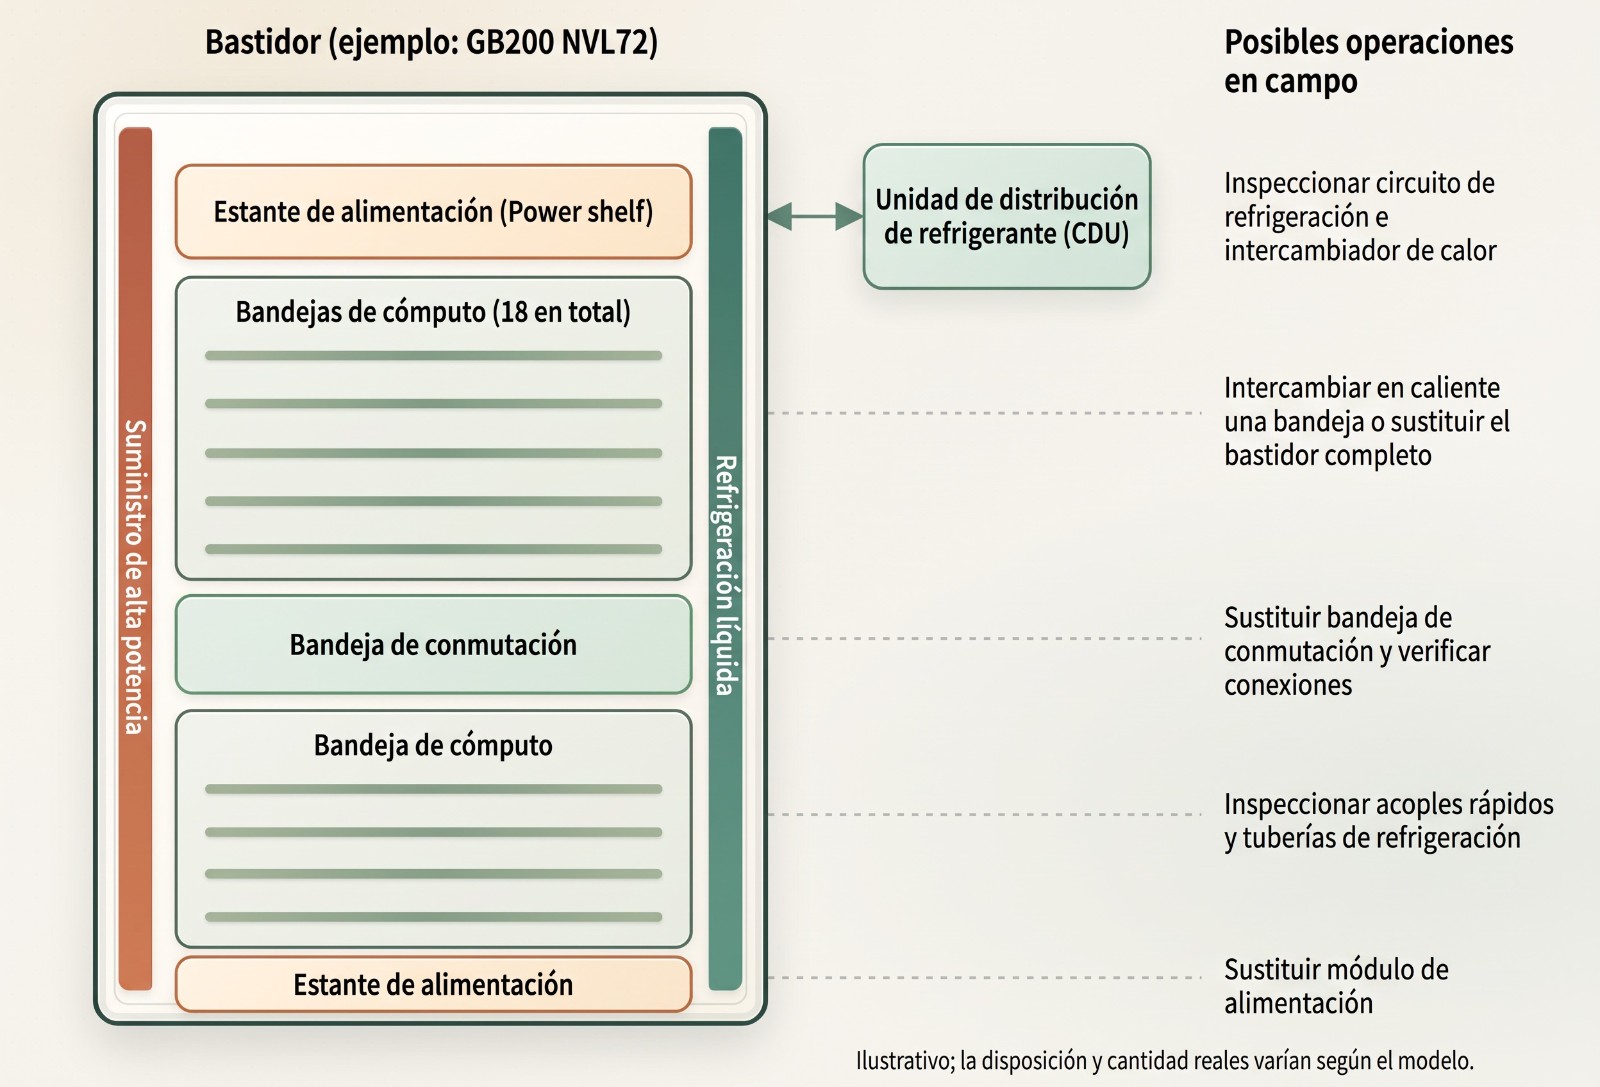
L11 instala varios nodos en el rack, completa el cableado de red y la integración de conmutadores, y amplía el objeto de las pruebas a todo el rack. Que el sistema completo supere las pruebas no significa que el funcionamiento entre nodos sea normal: la conectividad, el cableado y la coherencia de las versiones de firmware pasan a ser nuevas variables. Tomando como ejemplo el GB200 NVL72, los aproximadamente 120 kW de disipación se resuelven con refrigeración líquida directa, mediante colectores de refrigeración líquida de conexión ciega y conectores rápidos flotantes[7], y la ficha técnica de HPE recoge diseños de servicio con conexión y sustitución en caliente[8]. Las tareas en sitio abarcan la alimentación, la refrigeración líquida y la red (véase la Figura 4). |
Figura 4: Esquema del alcance de las tareas del servicio en sitio a nivel de rack[7][8] | ||||
Las necesidades de servicio posventa del nivel de rack se concentran en el tiempo de inactividad, la devolución al proveedor y los repuestos: | ||||
➤ Servicio en sitio: el alcance de la parada debe reducirse al mínimo | ||||
Los fallos suelen tener que atenderse en la sala de equipos del cliente, e implican la integración de alimentación, refrigeración líquida y red; un centro de datos no puede detenerse a la ligera, y la reparación de un nodo puede afectar a todo el clúster, por lo que el foco pasa de "cómo reparar" a "cómo reducir el alcance de la parada". |
➤ RTV: el cliente devuelve directamente al proveedor y los documentos deben cuadrar | ||||
Algunos clientes devuelven las piezas averiadas directamente al proveedor (RTV), sin pasar por la planta de ensamblaje; se necesitan registros de fallo y documentos claros para que las responsabilidades y las cantidades cuadren. | ||||
➤ Repuestos y análisis de big data: preposicionar y acumular de forma continua | ||||
Los repuestos deben preposicionarse según la ubicación del rack y el nivel de SLA (Service Level Agreement, acuerdo de nivel de servicio), con control de las existencias; los datos de reparación acumulados también deben poder sustentar el análisis de big data, como base para la asignación de repuestos y las decisiones de mejora. | ||||
Flujo en sitio: el ingeniero llega → localiza el servidor averiado → sustitución en caliente o sustitución del sistema completo → verificación del funcionamiento global. La solución consiste en adelantar el despacho y los repuestos: despachar según la ubicación del rack y el nivel de SLA, preposicionar los repuestos en el sitio, reducir el alcance de la parada mediante la sustitución en caliente y conservar al mismo tiempo los documentos de RTV y los registros de reparación. Esto requiere un mecanismo de despacho en sitio, control del cumplimiento de plazos del SLA, control de existencias de repuestos y análisis de big data. |
V. Cómo wareconn conecta el servicio integral desde los componentes hasta el rack | ||||
Las capacidades de sistema de las cuatro capas están estrechamente encadenadas: la trazabilidad de componentes sustenta la asociación de placas, los registros de combinación constituyen el historial del sistema completo, y este a su vez es la base del servicio en sitio; si se rompe cualquier capa, el rastreo de la causa raíz pierde su fundamento. wareconn utiliza tres funciones, "Definir producto / pieza", "Asociación producto–pieza" y "Múltiples tipos de garantía", para que los registros de garantía de los cuatro niveles se conserven en una misma plataforma (Figura 5). |
Figura 5: Esquema de las relaciones de datos entre productos, piezas y registros de garantía de wareconn | ||||
➤ Definir productos y piezas: | ||||
Los niveles de componente, de sistema completo y de rack se crean con "Definir producto", y el nivel de placa se crea con "Definir pieza"; pueden añadirse de uno en uno o cargarse por lotes descargando una plantilla. | ||||
➤ Asociación producto–pieza: | ||||
Tras seleccionar un producto, puede "Vincular piezas" indicando la cantidad, o usar "Alta y vinculación por lotes" de sistemas completos, piezas y sus asociaciones, lo que sustenta el seguimiento de asociaciones y el historial del sistema completo. | ||||
➤ Configurar los tipos de garantía según el nivel y el cliente: | ||||
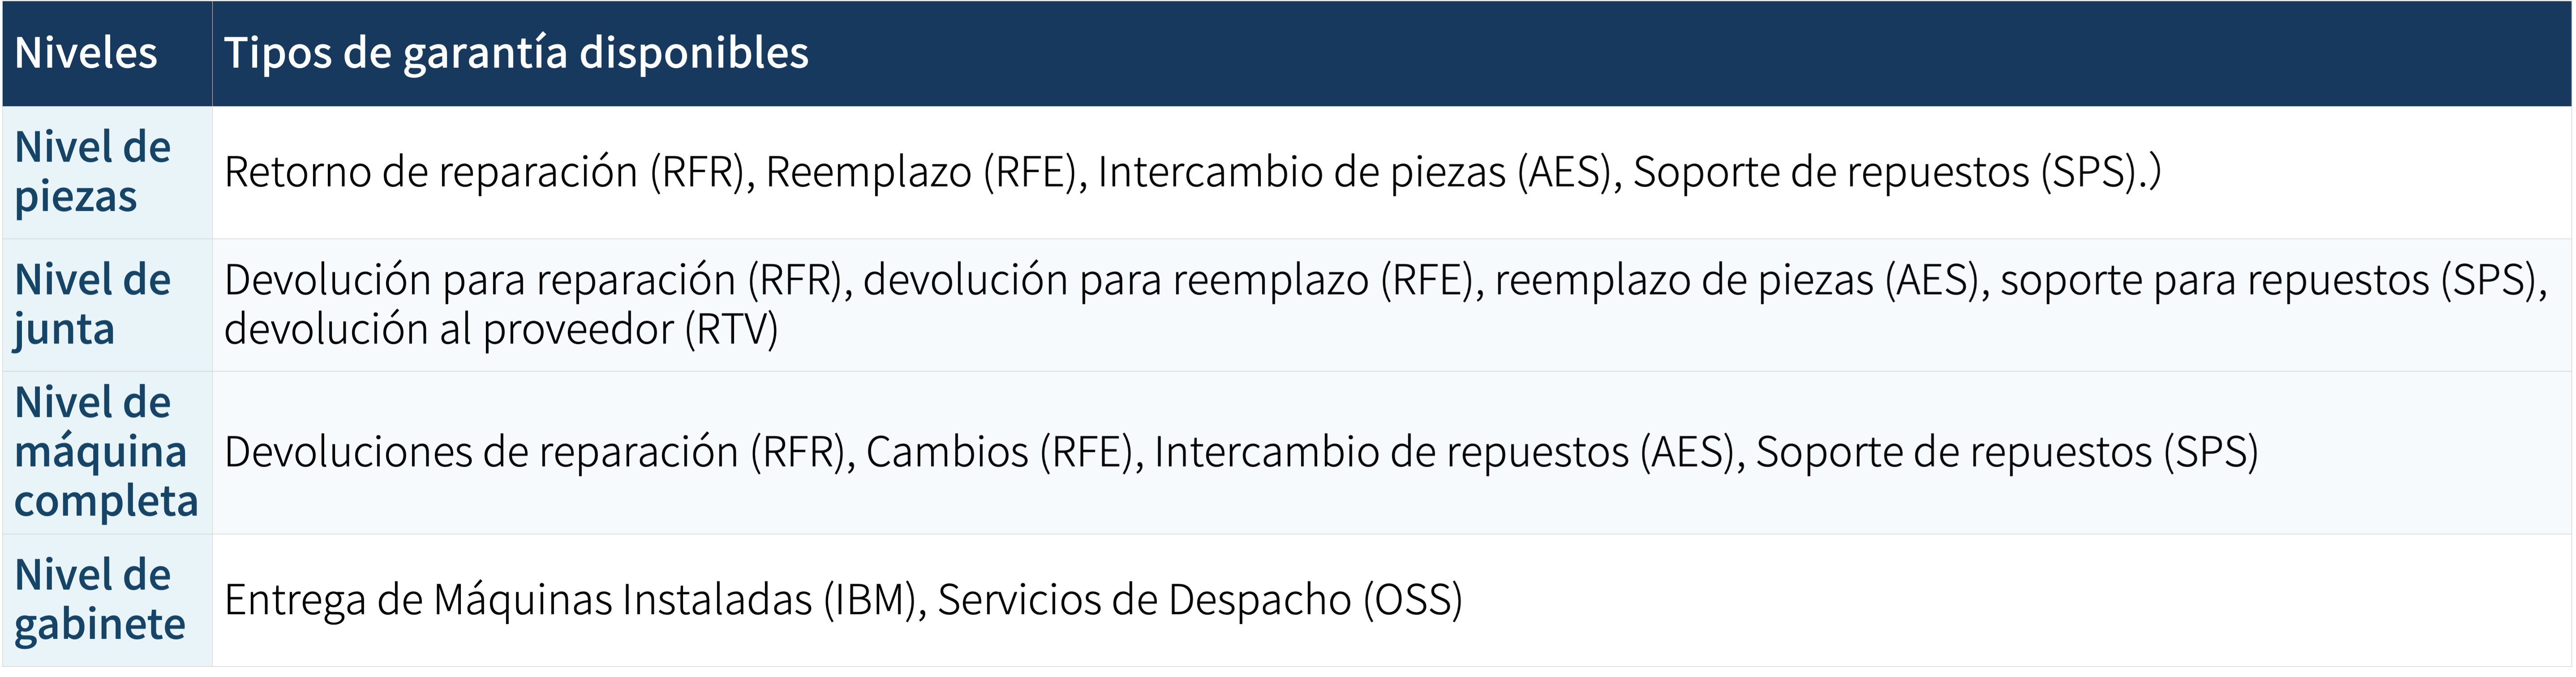
La configuración de garantía se realiza por cliente: los niveles de componente, de sistema completo y de rack se configuran por categoría de producto en "Garantía de producto", y el nivel de placa se configura por PN de pieza en "Garantía de pieza"; ambas admiten configuración por lotes (Tabla 1). |
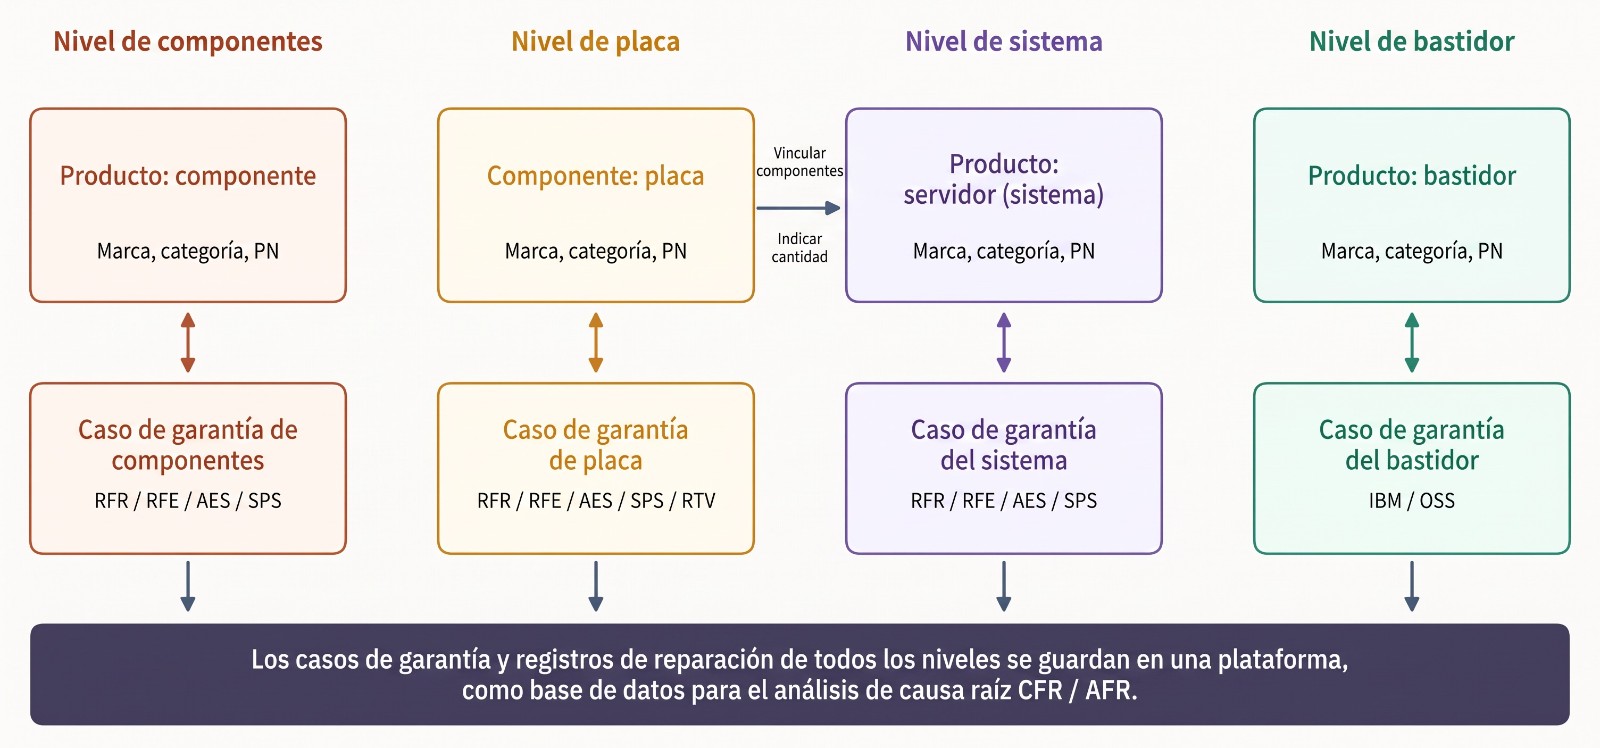
Tabla 1: Combinaciones de tipos de garantía de los cuatro niveles | ||||
Como el nivel de rack se despliega en las instalaciones del cliente, se basa principalmente en la entrega e instalación (IBM) y el servicio de despacho (OSS); el nivel de placa incluye además la devolución al proveedor (RTV). |
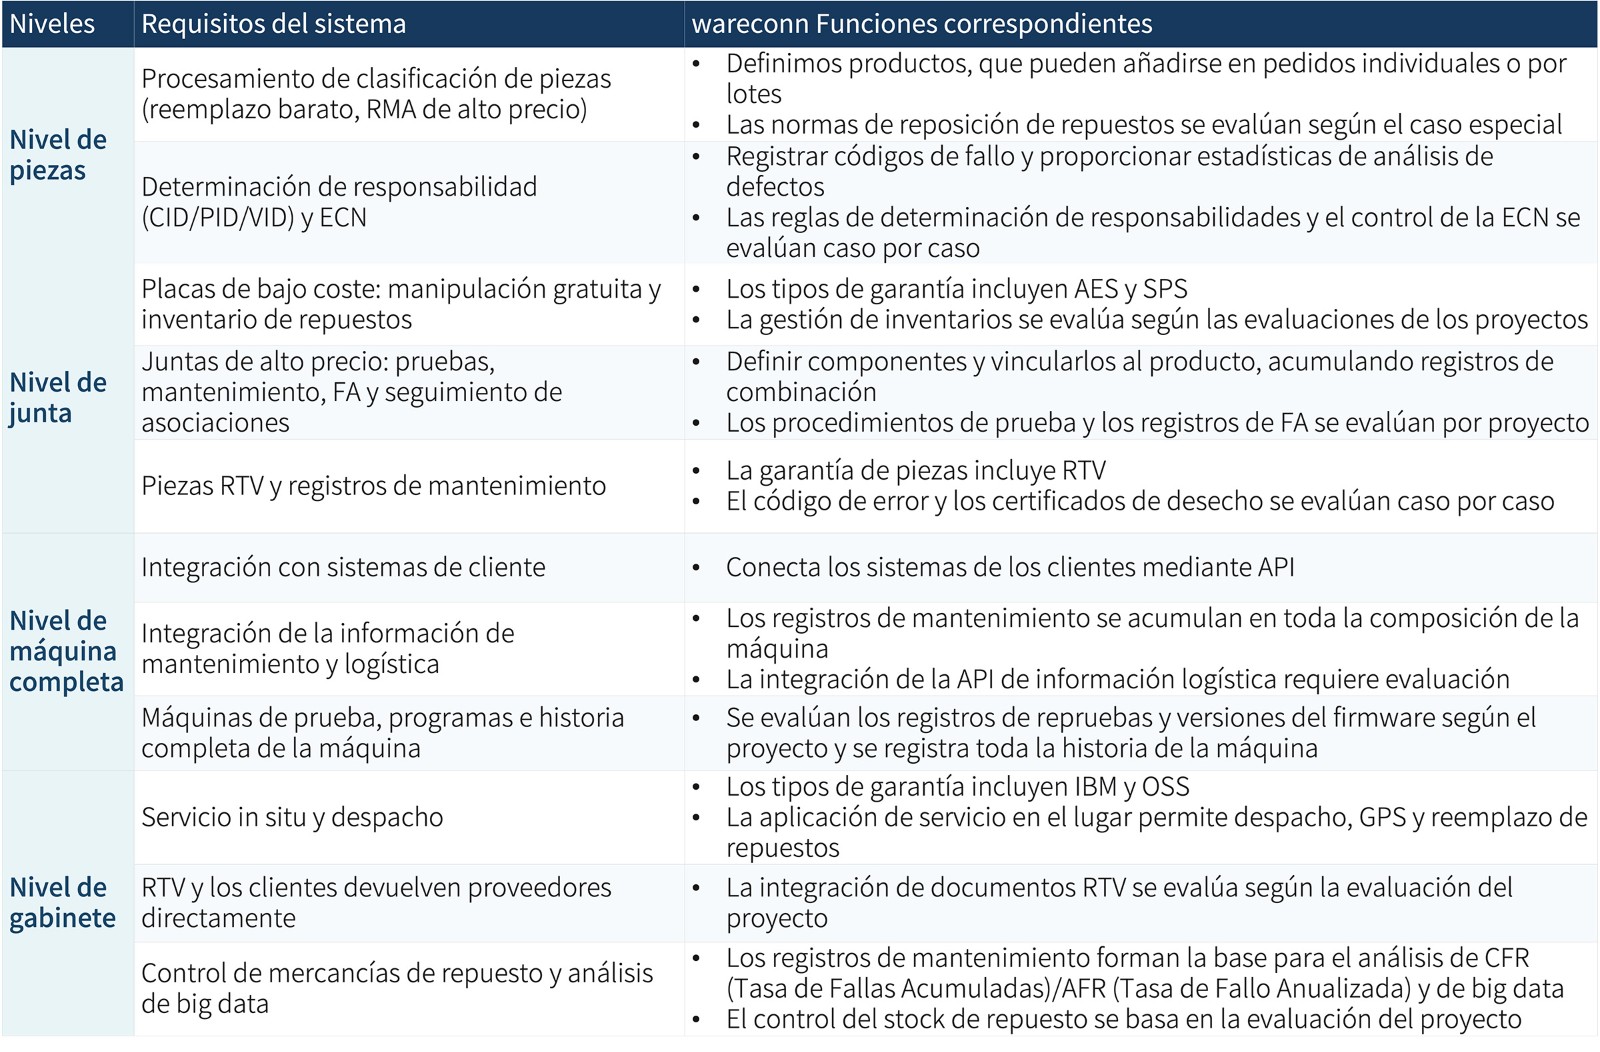
➤ Requisitos del sistema y correspondencia de funciones: | ||||
Tabla 2: Correspondencia entre los requisitos del sistema de cada capa y las funciones de wareconn | ||||
Una vez conectados los datos, ante una queja de un cliente las marcas fabricantes pueden recuperar rápidamente el historial completo desde el componente hasta el rack; estos registros estructurados son también la base del análisis de la tasa de fallos y de la causa raíz, lo que permite a las empresas mejorar de forma continua siguiendo el ciclo "estructurar los datos → analizar → mejorar → volver a observar"[5]. Entre las empresas del sector electrónico con mejor desempeño, la tramitación de reclamaciones de garantía lleva unos 5 días y el coste de garantía ronda el 1,8 % de los ingresos[4]. | ||||
Conclusión | ||||
Desde los componentes hasta el rack, los problemas posventa se extienden hacia fuera con cada capa: cuanto más abajo, más cerca de los componentes y de la cadena de suministro; cuanto más arriba, más implican integración de sistemas y servicio en sitio. La lógica de reparación difiere en cada capa, pero todas deben apoyarse en una base de datos que pueda rastrearse de arriba abajo y de abajo arriba. |
Autor
Departamento Editorial de wareconn
Guía completa del servicio posventa de servidores de IA, parte 1: los cuatro niveles de desafíos posventa, de los componentes al rack.pdf
Referencia
- AMAX, Manufacturing Level, AMAX Total Computing Solutions.
- Aly Pinder, 2022, Worldwide Manufacturing Product and Service Innovation 2023 Predictions, IDC FutureScape, IDC #US48627622.
- Wallace R. Blischke, M. Rezaul Karim, D. N. Prabhakar Murthy, 2011, Warranty Data Collection and Analysis, Springer.
- “Powering warranty reinvention: How electronics companies leverage new technologies to improve warranty management”, IBM Institute for Business Value, 2017.
- Albert Liao, 2022, Warranty Chain Management - Digitalization and Sustainability, Springer.
- Open Compute Project, Liquid Cooling Integration and Logistics White Paper, Revision 1.0 (CC BY-SA 4.0).
- NVIDIA, 2024, NVIDIA Contributes NVIDIA GB200 NVL72 Designs to Open Compute Project, NVIDIA Technical Blog.
- Hewlett Packard Enterprise, NVIDIA GB200 NVL72 by HPE QuickSpecs.
- Google Cloud, Proactive prevention: Inside Google Cloud's multi-layered GPU qualification process, Google Cloud Community.
- Crusoe, Burn-in validation, Crusoe Cloud Documentation.