Guía completa del servicio posventa de servidores de IA, parte 2: tres modelos de suministro, atribución de responsabilidades muy distinta
Publicado: Actualizado:
El artículo anterior utilizó la clasificación L1–L12 para tratar las necesidades posventa en cuatro niveles: componentes, placas, sistemas completos y racks. Sin embargo, cuando un equipo presenta un problema, quién asume la responsabilidad suele depender no del nivel en el que se averió la pieza, sino de «quién lo ensambló y quién responde». Según la forma de suministro, los servidores de IA se dividen a grandes rasgos en tres tipos: sistemas completos definidos y entregados por el fabricante original, sistemas completos ensamblados por un fabricante de servidores a partir de módulos centrales, y sistemas modulares de arquitectura abierta que pueden configurarse con flexibilidad. Para el propietario de la empresa, el modelo de suministro elegido en la compra determina también a quién acudir cuando surjan problemas, cómo se repara y cómo se reparte la responsabilidad. Este artículo explica, por orden, la atribución de responsabilidad y las necesidades posventa de los tres modelos y, por último, presenta cómo wareconn los atiende con una misma plataforma. I. Marca propia del fabricante original: una única ventanilla, servicio según el programa del fabricante La marca propia del fabricante original significa que el sistema completo es definido y entregado por el propio fabricante original. Un ejemplo es DGX: tiene como núcleo la placa base de 8 GPU de HGX, pero el sistema completo lo diseña y entrega el propio fabricante original [1][2]. Para el cliente es «todo incluido por el fabricante original», con un único punto de responsabilidad. Las necesidades de servicio posventa se concentran en la interacción con el fabricante original: |
➤ Una única ventanilla, servicio según el programa del fabricante | ||||
Tomando DGX como ejemplo, según la hoja de datos de servicios de soporte empresarial publicada por el fabricante original en 2020, debe acompañarse del contrato de servicios de soporte del fabricante, que abarca soporte de hardware y software durante todo el ciclo de vida, sustitución anticipada (Advanced RMA) con entrega al siguiente día hábil (según la región) y soporte para el sistema operativo, los controladores y el firmware [3]. Por ello, la determinación de responsabilidad se concentra en el fabricante original, y los plazos y el método de reparación o sustitución dependen de su programa. Las piezas de repuesto también se proporcionan según el programa: tomando como ejemplo el DGX-1 de 2018, el programa de repuestos del fabricante original cubre piezas específicas como fuentes de alimentación, ventiladores y memoria, y que se suministren o no lo decide cada distribuidor o socio [4]. | ||||
➤ El proceso de envío a reparación debe coincidir con el del fabricante original | ||||
Los equipos deben enviarse a reparación siguiendo el proceso que especifica el fabricante original, y los registros del lado del cliente deben ser coherentes con las órdenes de trabajo del fabricante. Si una empresa gestiona a la vez sistemas del fabricante original y equipos de otras marcas, los registros quedan dispersos y los períodos de garantía y el avance de las reparaciones pueden desajustarse con facilidad. Las piezas de repuesto sustituidas tienen además su propio período de garantía: por ejemplo, en el programa de repuestos del DGX-1, si una pieza de repuesto se envía dentro de los últimos 90 días del período de soporte, recibe 90 días de soporte de hardware (si se envió antes, la cobertura llega hasta el final del período de soporte) [4], y esto también debe registrarse pieza por pieza. | ||||
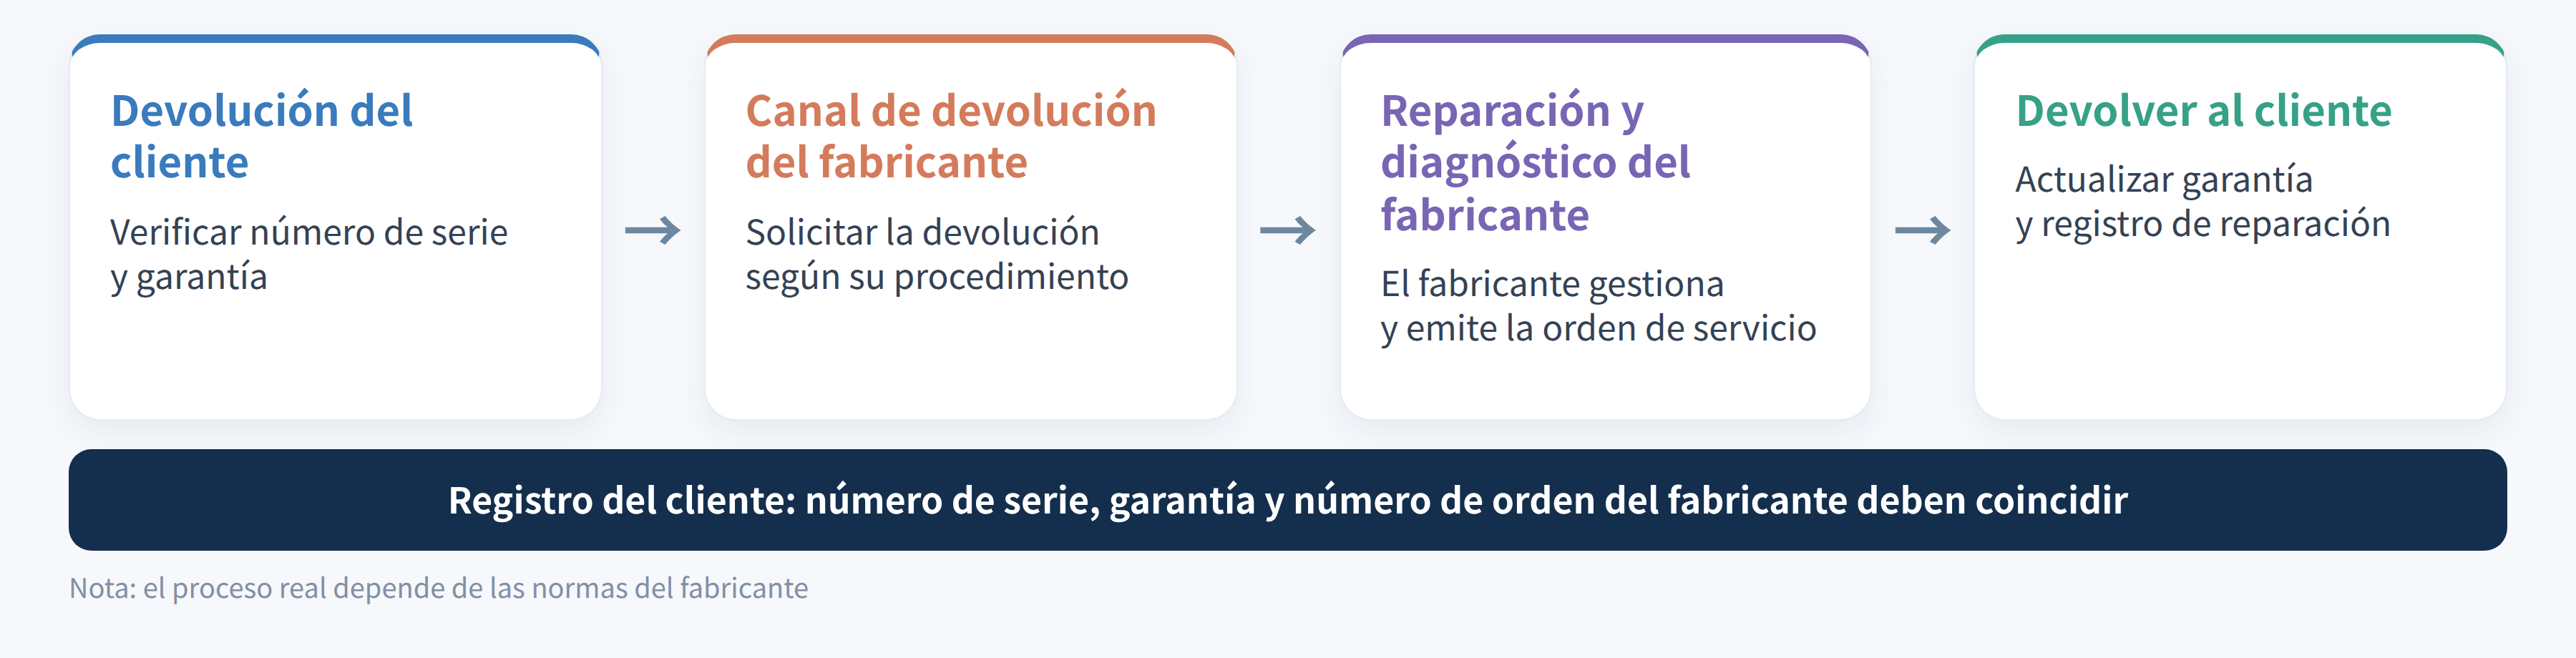
Para atender estas necesidades, el enfoque consiste en estandarizar el envío a reparación y registrar el número de serie de cada equipo, su período de garantía y el número de orden de trabajo del fabricante original, de modo que el envío a reparación, la devolución y el estado de la garantía queden documentados (véase la Figura 1). | ||||
Figura 1: Esquema del proceso de reparación del fabricante original y de los registros del lado del cliente |
II. Integración por OEM: responsabilidad entre tres partes, SOP distintos La integración por OEM significa que el propietario de la marca proporciona los módulos centrales y el fabricante de servidores (OEM) selecciona las demás piezas y ensambla el sistema completo. Un ejemplo son los servidores con placa base HGX: HGX es una plataforma de placa base de GPU que se suministra a los fabricantes de servidores, e incluye las GPU y los módulos de interconexión de alta velocidad, mientras que el fabricante selecciona por su cuenta la CPU, la memoria, el almacenamiento y el chasis [1][2]; el HGX más reciente se ofrece como una única placa base con ocho GPU, que puede combinarse con una placa de CPU x86 o de otra arquitectura [2]. El propietario de la marca, el OEM y el entorno de uso del cliente hacen que en un mismo equipo intervengan tres partes. Las necesidades de servicio posventa se concentran en la determinación de responsabilidad y en las diferencias de proceso: |
➤ Responsabilidad entre tres partes: la determinación VID/PID es compleja | ||||
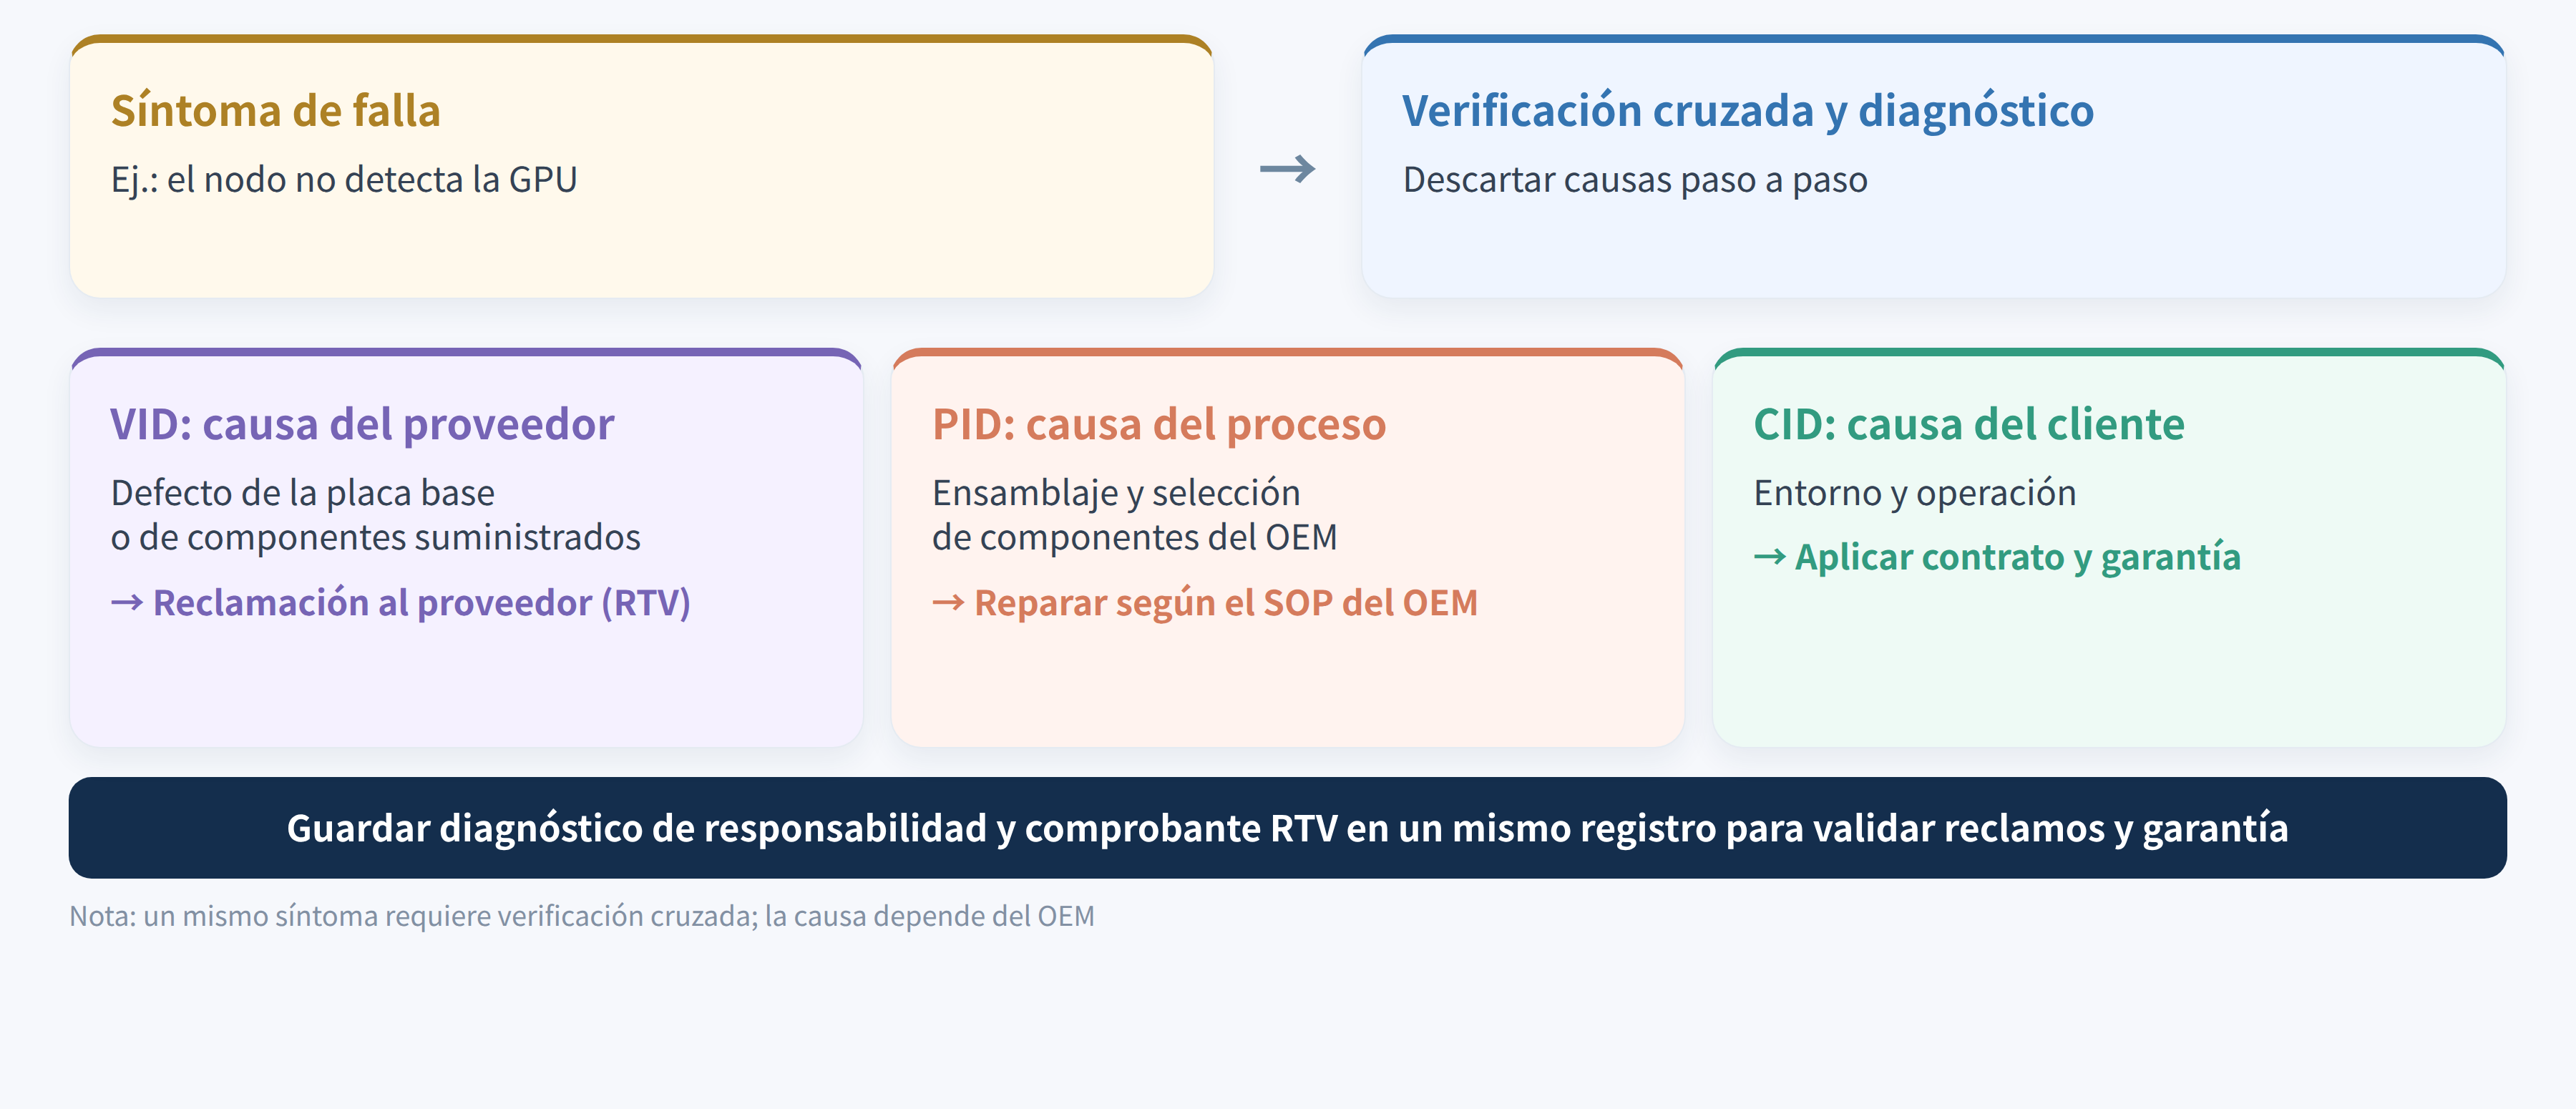
Desde la perspectiva del OEM, los defectos de la propia placa base y de las piezas son atribuibles al proveedor (VID), el diseño inadecuado del ensamblaje o de la selección de componentes es atribuible al proceso (PID), y el uso indebido es atribuible al cliente (CID). Tomando HGX como ejemplo, la parte de GPU tiene una topología fijada por la placa base, mientras que el resto de periféricos los diseña cada fabricante [1]; por ello, el diagnóstico de averías debe distinguir primero si el problema está en la placa base o en la alimentación, la refrigeración o el ensamblaje elegidos por el OEM; por ejemplo, si un nodo no detecta la GPU tras arrancar, se requiere una verificación cruzada para llegar a una conclusión. Cuando la atribución no está clara, el resarcimiento y la garantía generan fácilmente disputas. | ||||
➤ Cada fabricante tiene SOP distintos | ||||
Incluso entre modelos de integración por OEM, las condiciones de garantía y los procesos de envío a reparación varían de un OEM a otro. Tomando como ejemplo condiciones públicas, la garantía estándar de un OEM para sistemas de GPU es de 3 años de mano de obra, 1 año de piezas y 1 año de envío anticipado de reemplazo, y las devoluciones requieren obtener antes un número RMA [5]; las condiciones públicas de otro OEM establecen que el período de garantía limitada de hardware depende del producto y puede ser de 90 días, de 1 a 5 años u otros plazos, y que se pueden adquirir por separado períodos de servicio más largos mediante servicios de soporte avanzado [6]. Los períodos de garantía de mano de obra y de piezas de un mismo equipo también pueden diferir (como los 3 años de mano de obra y 1 año de piezas del OEM mencionado), por lo que los registros de garantía deben poder llevarse por separado para determinar si una pieza sustituida sigue en garantía [5]. Si una empresa compra a varios OEM, no puede aplicar un único proceso a todos; de lo contrario, el método y el plazo del envío a reparación no coincidirán con el contrato. | ||||
Para atender estas necesidades, deben establecerse SOP de reparación y tipos de garantía por separado para cada marca de OEM, y conservarse los resultados de la determinación de atribución y los documentos RTV, de modo que los problemas de la placa base o de las piezas puedan rastrearse hasta el origen y que la responsabilidad y las cantidades cuadren (véase la Figura 2). Los datos del envío a reparación también deben prepararse con antelación: tomando como ejemplo el OEM anterior, primero debe obtenerse el número RMA y marcarse en la caja exterior del artículo devuelto [5]; si el modelo del producto, el número de serie y la descripción de la avería ya constan en el mismo registro, pueden verificarse rápidamente en el momento del envío. | ||||
Figura 2: Esquema de la determinación de responsabilidad entre tres partes en modelos de integración por OEM |
III. Suministro modular y flexible: configuraciones diversas, difíciles de gestionar con un único estándar El suministro modular y flexible significa que el fabricante del sistema parte de una arquitectura base abierta y selecciona por su cuenta los módulos de cómputo, red y almacenamiento. Un ejemplo es la arquitectura de referencia MGX: permite elegir libremente GPU, DPU y CPU para componer más de 100 variantes de servidor, compatibles con hardware de las generaciones actuales y futuras [7]; los artículos técnicos del fabricante original también utilizan MGX para explicar el diseño de los sistemas en rack [8]. Las necesidades de servicio posventa provienen de la diversidad de configuraciones: |
➤ Muchos SKU, configuraciones personalizadas | ||||
Bajo un mismo nombre de modelo, las combinaciones de CPU, GPU, tarjeta de red y refrigeración pueden ser todas distintas; el fabricante original explica que MGX admite cientos de combinaciones de GPU, DPU, CPU, almacenamiento y red [8]. Si las piezas de repuesto y las reparaciones se gestionan solo por modelo, es fácil almacenar la pieza equivocada o aplicar un proceso erróneo, y además al cliente le resulta difícil confirmar exactamente qué configuración tiene su equipo. | ||||
➤ La mezcla de generaciones es difícil de gestionar con un único estándar | ||||
Una arquitectura modular puede ser compatible con hardware de varias generaciones, por lo que en una misma sala de servidores pueden coexistir equipos de distintas generaciones, con requisitos de firmware y de compatibilidad diferentes que un único estándar de reparación difícilmente puede abarcar. Tomando como ejemplo el rack MGX, la bandeja de cómputo se compone de combinaciones de CPU y GPU, entre otras, e incluye componentes de refrigeración como placas frías de refrigeración líquida [8], por lo que las condiciones de nueva prueba tras sustituir una pieza también deben ajustarse a la configuración. | ||||
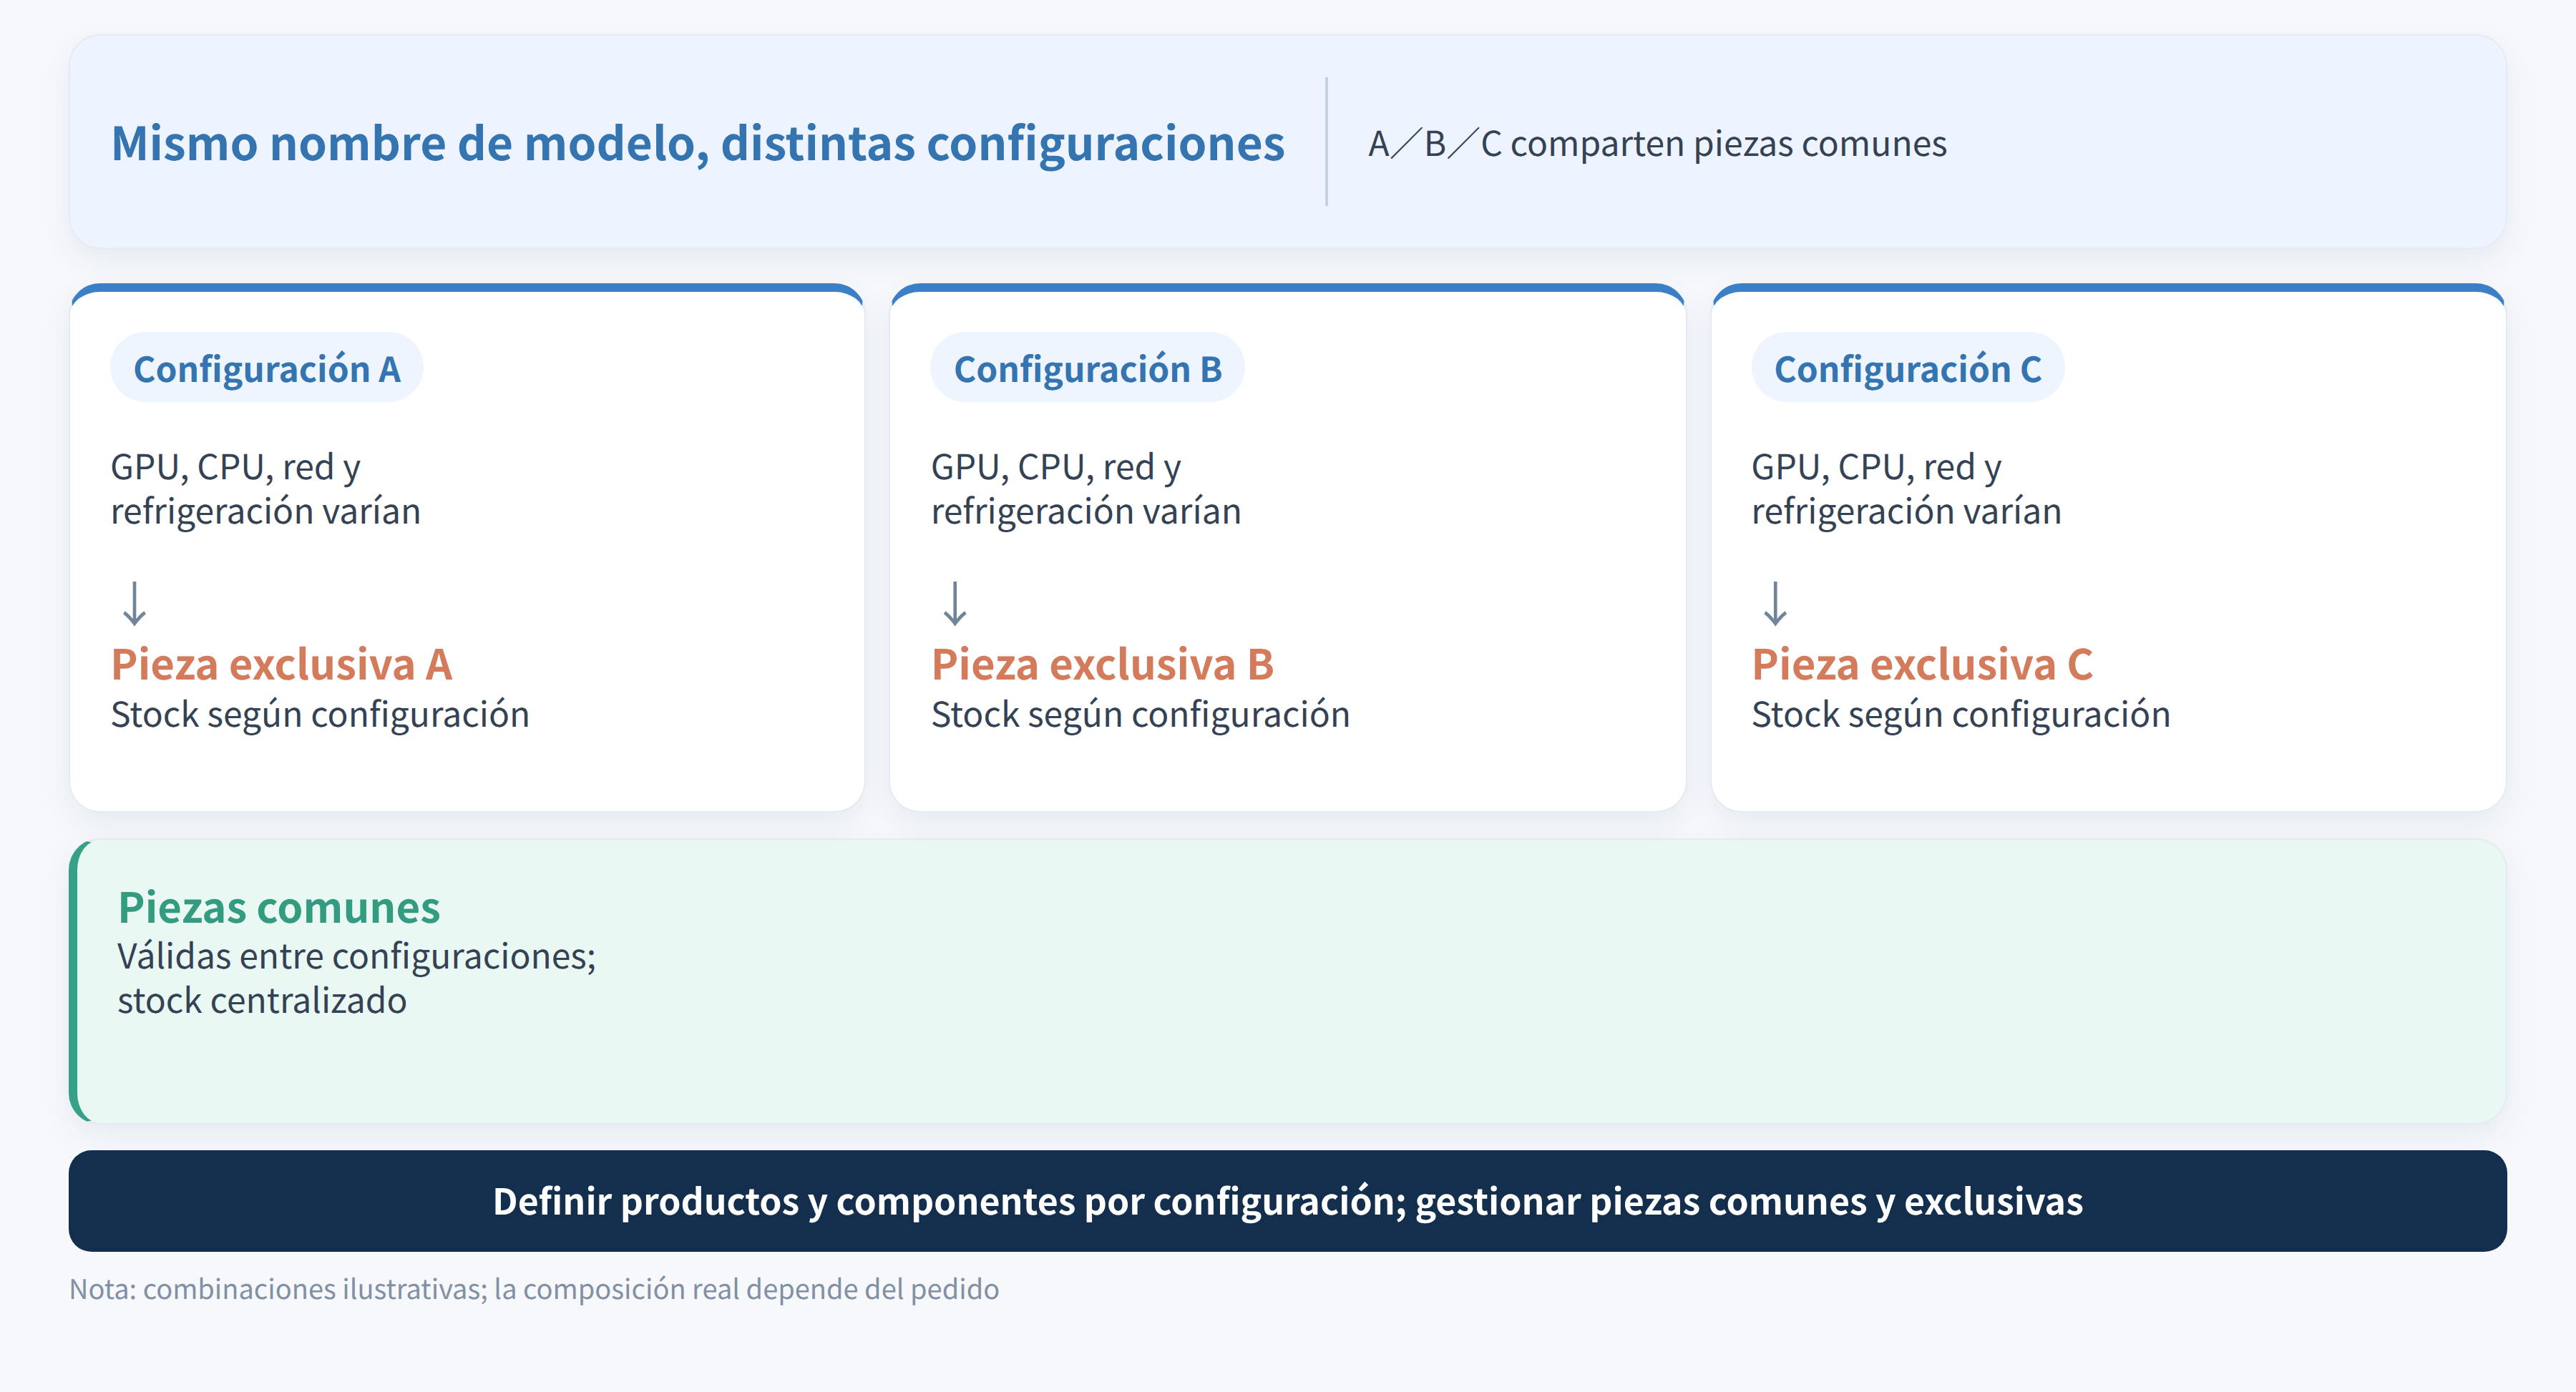
Para atender estas necesidades, es preciso definir los productos y las piezas según la configuración real, y gestionar las piezas de repuesto en dos categorías, piezas compartidas y piezas dedicadas: las piezas compartidas, comunes a distintas configuraciones, se almacenan de forma centralizada, mientras que las piezas dedicadas, usadas solo en configuraciones específicas, se almacenan por configuración (véase la Figura 3). Las investigaciones de teoría de inventarios señalan que, bajo restricciones de nivel de servicio, el uso de piezas compartidas beneficia al inventario, pero no existe una conclusión de aplicación general sobre cómo varía el nivel de inventario de cada pieza [9]; por ello, los niveles de existencias de ambas categorías de piezas de repuesto deben seguir fijándose uno por uno según el uso real y el coste. | ||||
Figura 3: Esquema de la configuración modular y la gestión de piezas de repuesto |
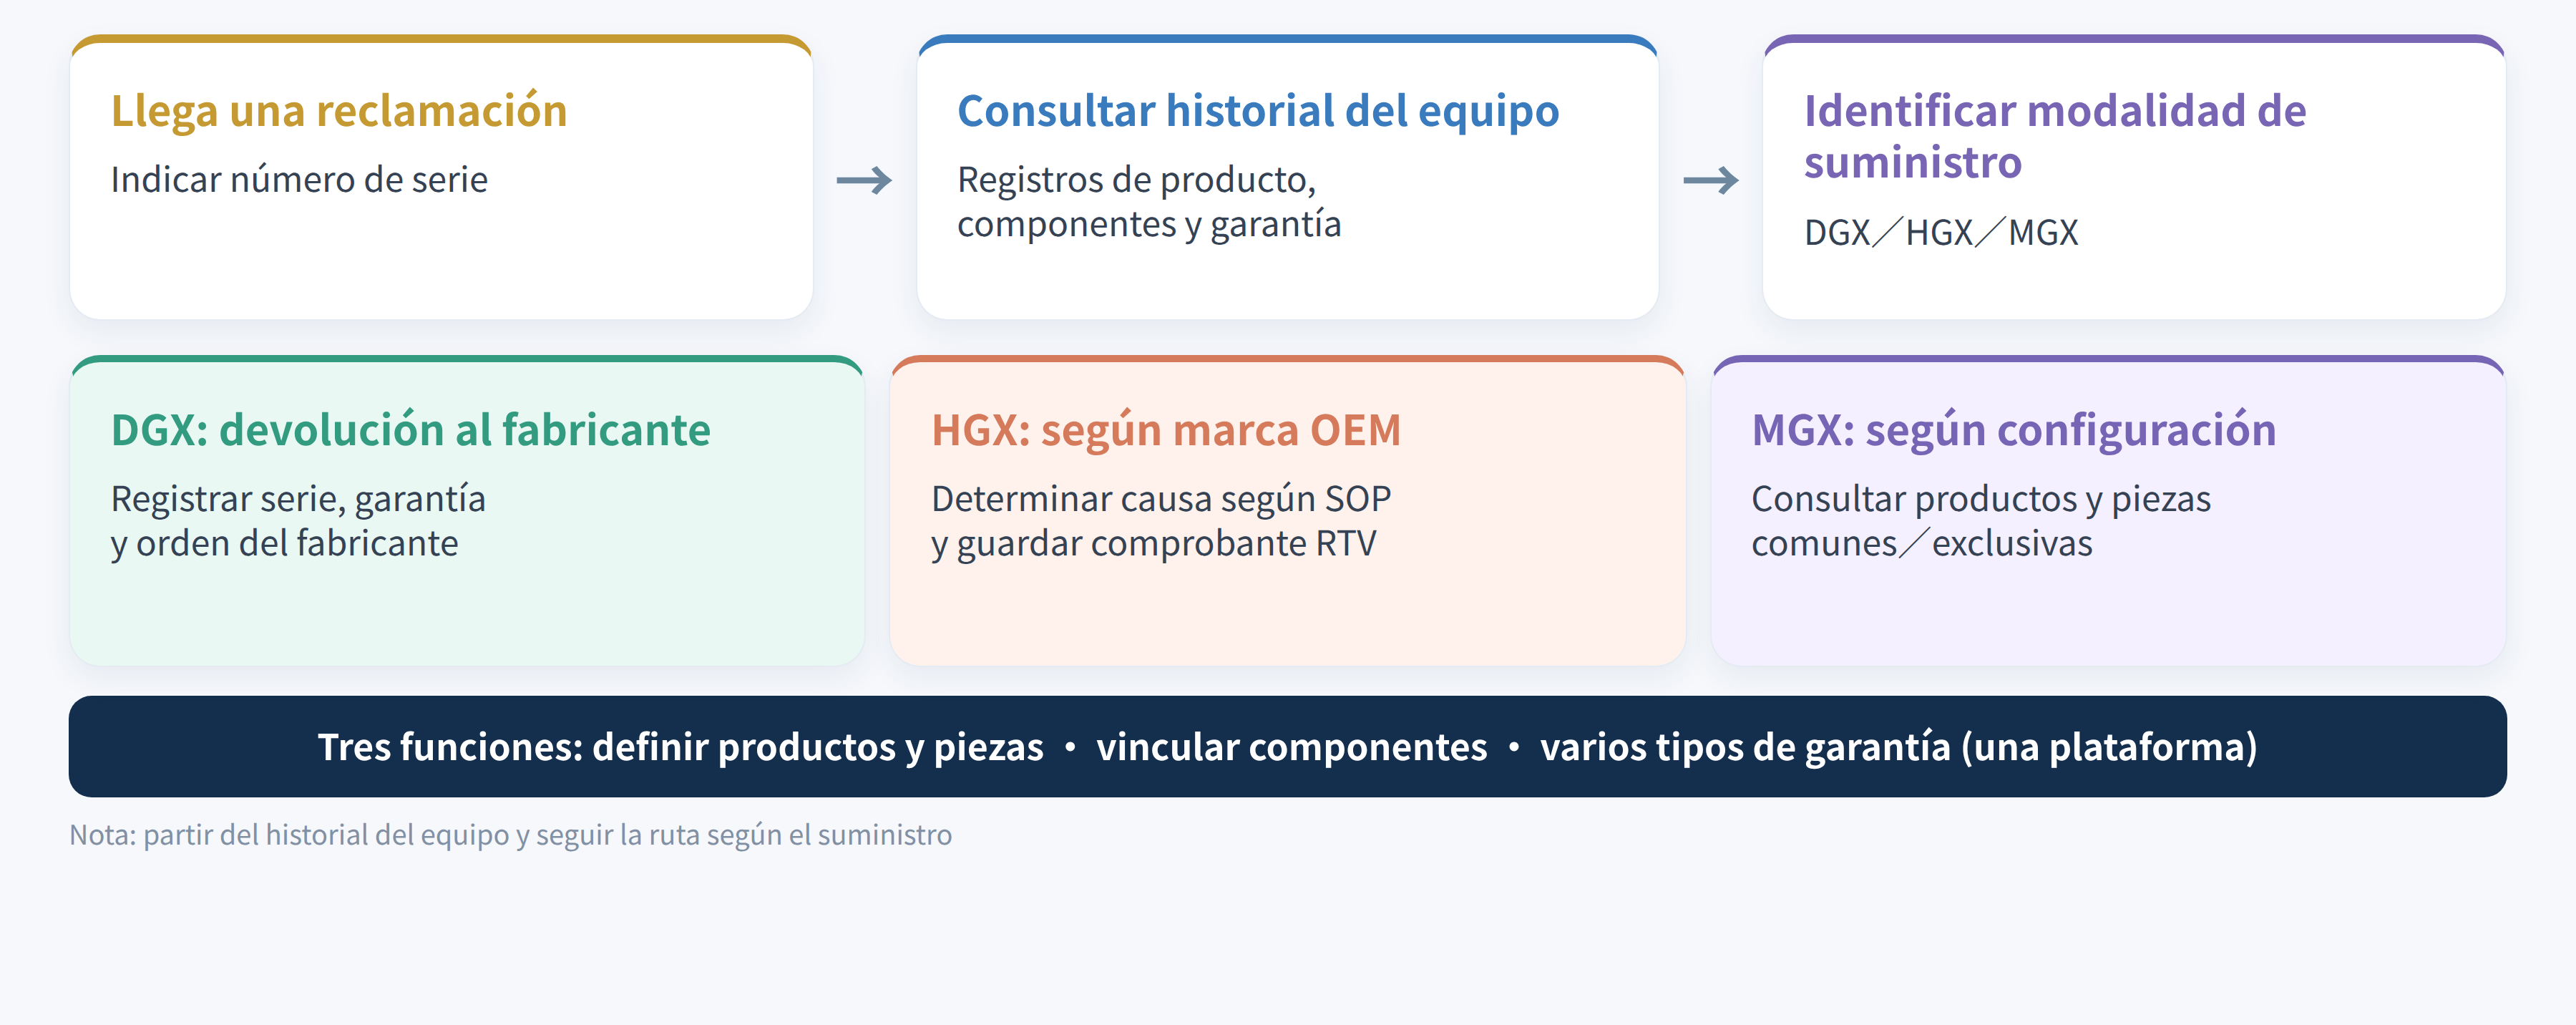
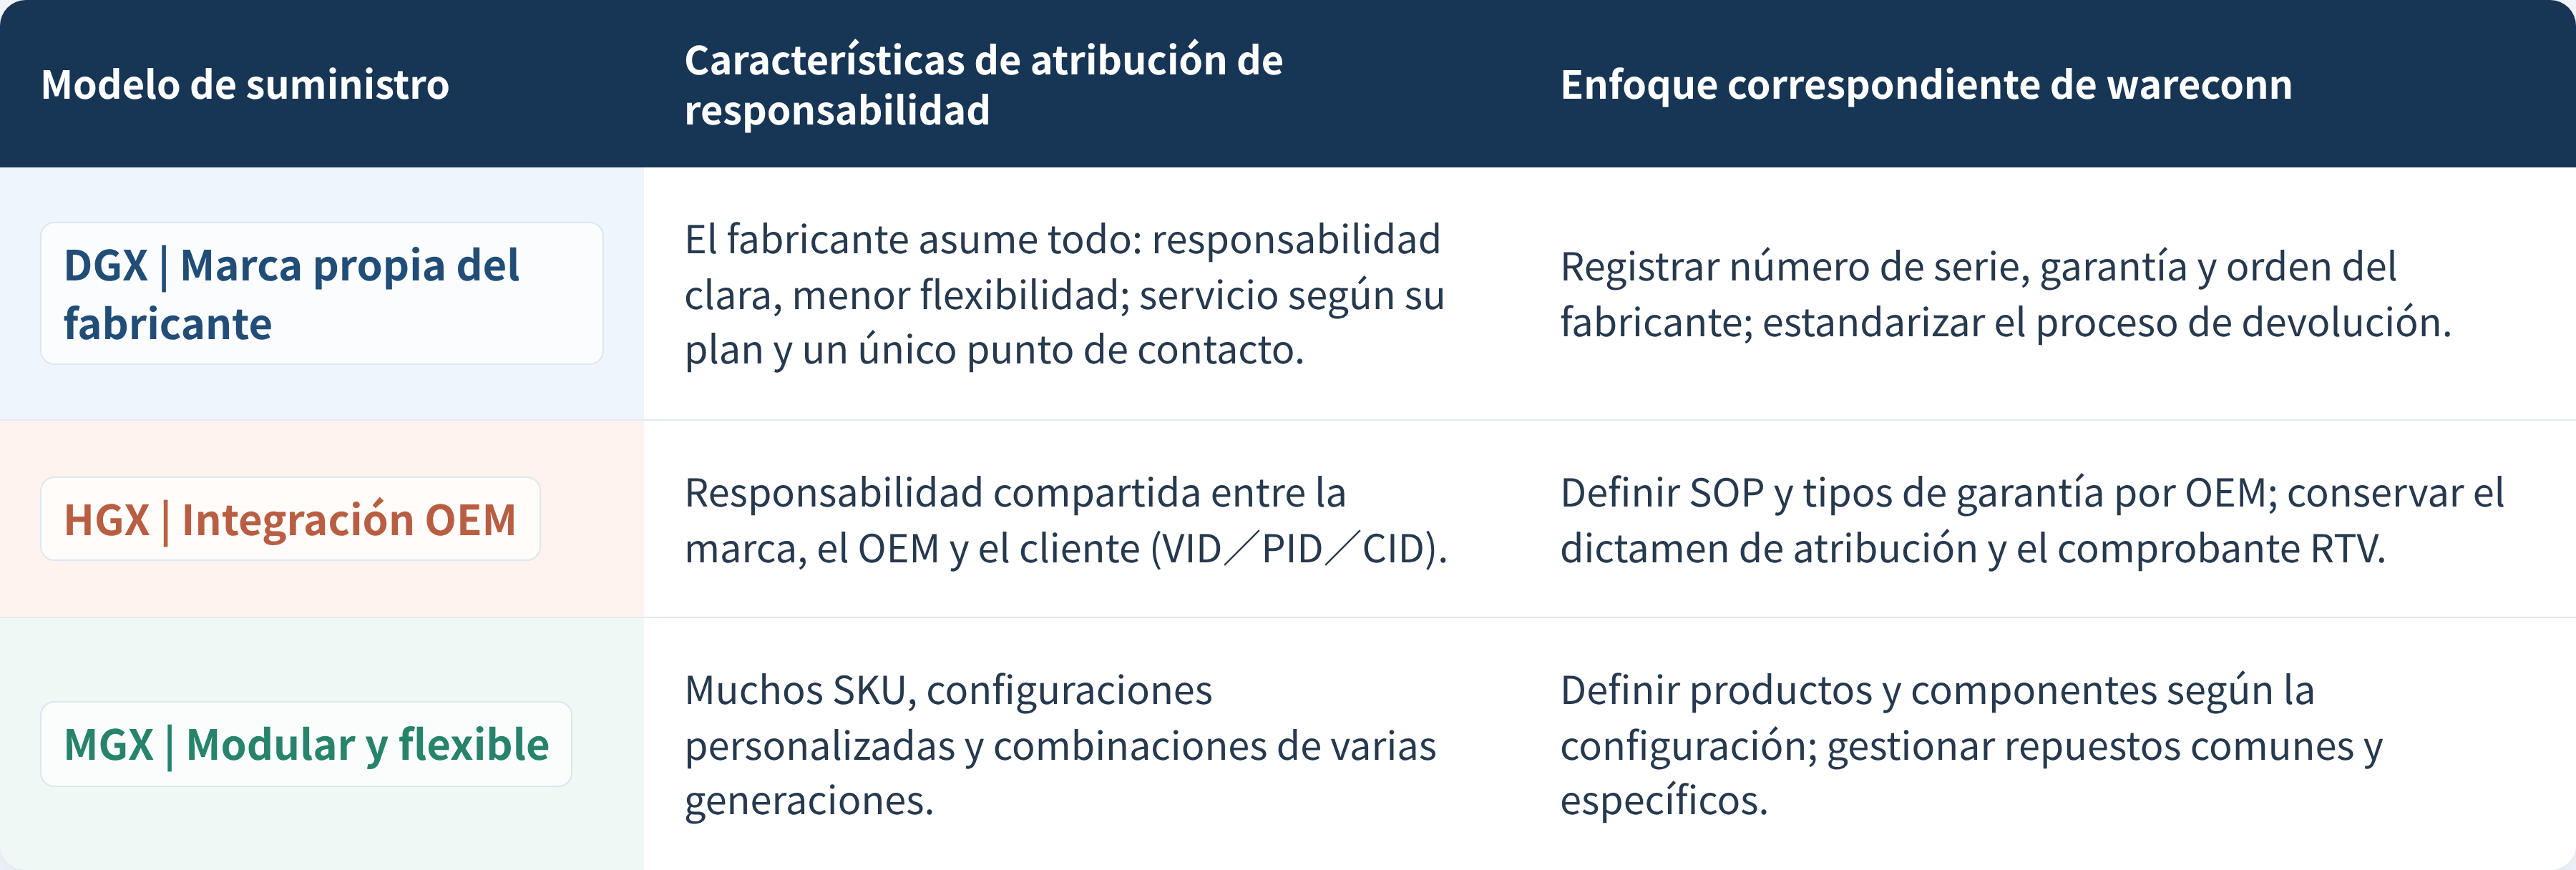
IV. Cómo responde wareconn a los tres modelos de suministro Los tres modelos difieren en la atribución de responsabilidad y en las prioridades posventa (Tabla 1), pero comparten un punto común en la gestión: quién suministró el equipo, quién lo ensambló, de qué piezas se compone y qué garantía le es aplicable deben dejar un registro trazable. wareconn gestiona con una plataforma unificada los registros y la atribución de responsabilidad a lo largo de la cadena de suministro, y retoma las tres funciones del artículo anterior: «Definir producto/pieza», «Asociación producto-pieza» y «Múltiples tipos de garantía». Cuando llega una queja de un cliente, primero se consultan los registros de producto, piezas y garantía del equipo para confirmar a qué modelo de suministro pertenece, y después se sigue la ruta correspondiente de envío a reparación, determinación o piezas de repuesto (véase la Figura 4). |
Figura 4: Rutas de tratamiento de los tres modelos de suministro enlazadas mediante el historial del equipo | ||||
Tabla 1: Atribución de responsabilidad de los tres modelos de suministro y enfoques correspondientes de wareconn | ||||
Los SLA y la estrategia de piezas de repuesto también pueden configurarse con flexibilidad según el modelo de suministro y las necesidades del cliente, sin necesidad de crear un sistema distinto para cada modelo. Por ejemplo, los sistemas del fabricante original deben acompañarse del contrato de servicios de soporte del fabricante [3], y el período del contrato también debe conservarse junto con el número de serie del equipo y su período de garantía. Una vez que la atribución de responsabilidad y los registros de reparación se conservan de forma estructurada, también pueden servir de base para el análisis continuo y para mejorar los costes de garantía y la fiabilidad del producto [10]. |
Conclusión Solo viendo a qué modelo de suministro pertenece un equipo se puede aplicar la atribución de responsabilidad y la ruta de reparación correctas: en la marca propia del fabricante original, lo importante es la interacción con el envío a reparación y los contratos del fabricante; en la integración por OEM, comparar las condiciones de cada OEM y determinar la atribución; y en el suministro modular y flexible, gestionar las piezas de repuesto por configuración. El artículo anterior trató las necesidades posventa de cada nivel, y este trata la atribución de responsabilidad de cada modelo de suministro; lo que ambos tienen en común es que se necesitan datos trazables para que la responsabilidad y las rutas de reparación cuadren. |
Autor
Dr. Albert Liao Founder and CEO of Wareconn Technology Services (wareconn.com), Author of “Warranty Chain Management - Digitalization and Sustainability”, Springer
Guía completa del servicio posventa de servidores de IA, parte 2: tres modelos de suministro, atribución de responsabilidades muy distinta.pdf
Referencia
- ServeTheHome, NVIDIA DGX versus NVIDIA HGX – What is the Difference, ServeTheHome.
- NVIDIA, NVIDIA HGX Platform, NVIDIA Data Center.
- NVIDIA, 2020, NVIDIA DGX Systems Enterprise Support Services, NVIDIA.
- NVIDIA, 2018, NVIDIA DGX-1 Onsite Spares Services, NVIDIA.
- Supermicro, Limited Warranty, Supermicro Support.
- Dell Technologies, Limited Hardware Warranties, Dell
- NVIDIA, 2023, NVIDIA MGX Gives System Makers Modular Architecture to Meet Diverse Accelerated Computing Needs of World’s Data Centers, NVIDIA Press Release (COMPUTEX, May 28, 2023).
- NVIDIA, Building the Modular Foundation for AI Factories with NVIDIA MGX, NVIDIA Technical Blog.
- Yigal Gerchak, Michael J. Magazine, A. Bruce Gamble, 1988, Component Commonality with Service Level Requirements, Management Science, 34(6), 753–760.
- Albert Liao, 2022, Warranty Chain Management - Digitalization and Sustainability, Springer.
Artículos relacionados
La escala de despliegue de los servidores de IA sigue creciendo, y las formas del equipo se apilan capa por capa, desde componentes y placas hasta sistemas completos y racks.
Uno de los aspectos más subestimados de los datos de garantía es que las empresas suelen utilizarlos únicamente para detectar problemas, sin profundizar en la pregunta de «por qué ocurrieron»: ¿se debieron a un defecto de diseño, a un proceso de fabricación o a la calidad de un componente suministrado por un proveedor?
Los centros de servicio deben hacer seguimiento simultáneo cada día de cuatro indicadores interconectados —entradas, producción, WIP (trabajo en curso) y TAT medio— que están estrechamente relacionados entre sí: si el volumen de entradas supera de forma sostenida al volumen de producción, el WIP inevitablemente se acumulará con rapidez, lo que a su vez perjudica el TAT.
En el artículo anterior, analizamos el impacto estructural de la Directiva (UE) 2024/1799 sobre el ámbito de los productos, los periodos de suministro de piezas de repuesto, la lógica de ampliación de la garantía y las obligaciones de divulgación de información. Este artículo se centra en lo que las empresas realmente deben hacer: ante unas normas que entrarán en vigor simultáneamente en toda la UE a partir del 31 de julio de 2026, ¿qué secuencia deben seguir las empresas para cumplir? ¿Qué requisitos plantea la plataforma en línea europea de reparación? ¿Qué funciones deben evaluarse al valorar un sistema de gestión de reparaciones? ¿Qué ventajas aporta elegir la herramienta adecuada? El artículo concluye explicando cómo la plataforma wareconn puede ayudar a las empresas a afrontar esta transición.

La Directiva (UE) 2024/1799 se aplica desde el 31 de julio de 2026. Obligación de reparar, 12 meses más de garantía y cómo adaptar la posventa.